MotivMouse
MotivMouse — это сервис для обработки аудиоконтента, который преобразует речь в текст, анализирует смысл сказанного и генерирует озвученные ответы.
В кратце: идея сервиса превратить аудиоввод в структурированную информацию и обратно в голос.
MotivMouse — сервис обработки аудиоконтента с распознаванием речи, извлечением фактов из текста через LLM (Gemini) и синтезом речи для генерации аудиоответов.
Проект:
- принимает .wav аудиофайлы
- выполняет распознавание речи (STT)
- анализирует текст и извлекает конкретные факты с помощью LLM
- генерирует новый текст и выполняет синтез речи (TTS)
Стек технологий и их роль:
- Google Cloud Speech-to-Text
- Vertex AI Gemini API
- Синтез речи (TTS)
Роль технологий в проекте:
Google Cloud Speech-to-Text
Сервис распознавания речи для преобразования аудио в текст (STT): поддержка .wav, высокая точность, работа с разными языками и шумами
Vertex AI Gemini API
API мультимодальной LLM (Gemini) для семантического анализа и понимания текста: анализ текста, извлечение фактов (information extraction), генерация структурированных ответов
Синтез речи (TTS)
Синтез речи (TTS) через Google Cloud или связанный сервис для возврата результата пользователю в аудиоформате: генерация аудио из текста, естественное звучание
Архитектура проекта (упрощённо)
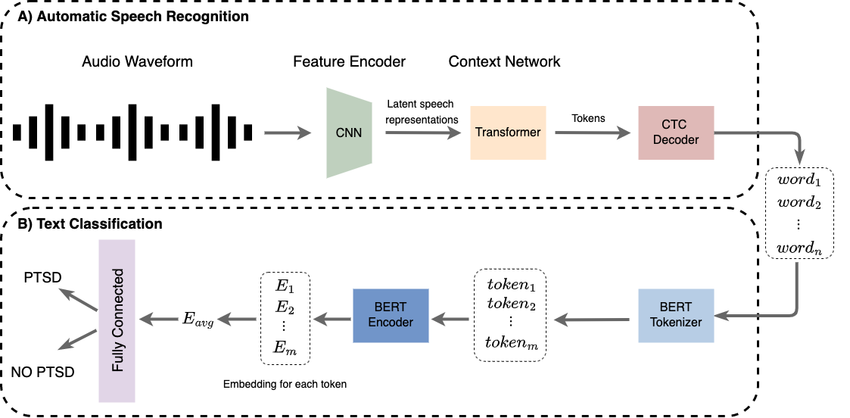
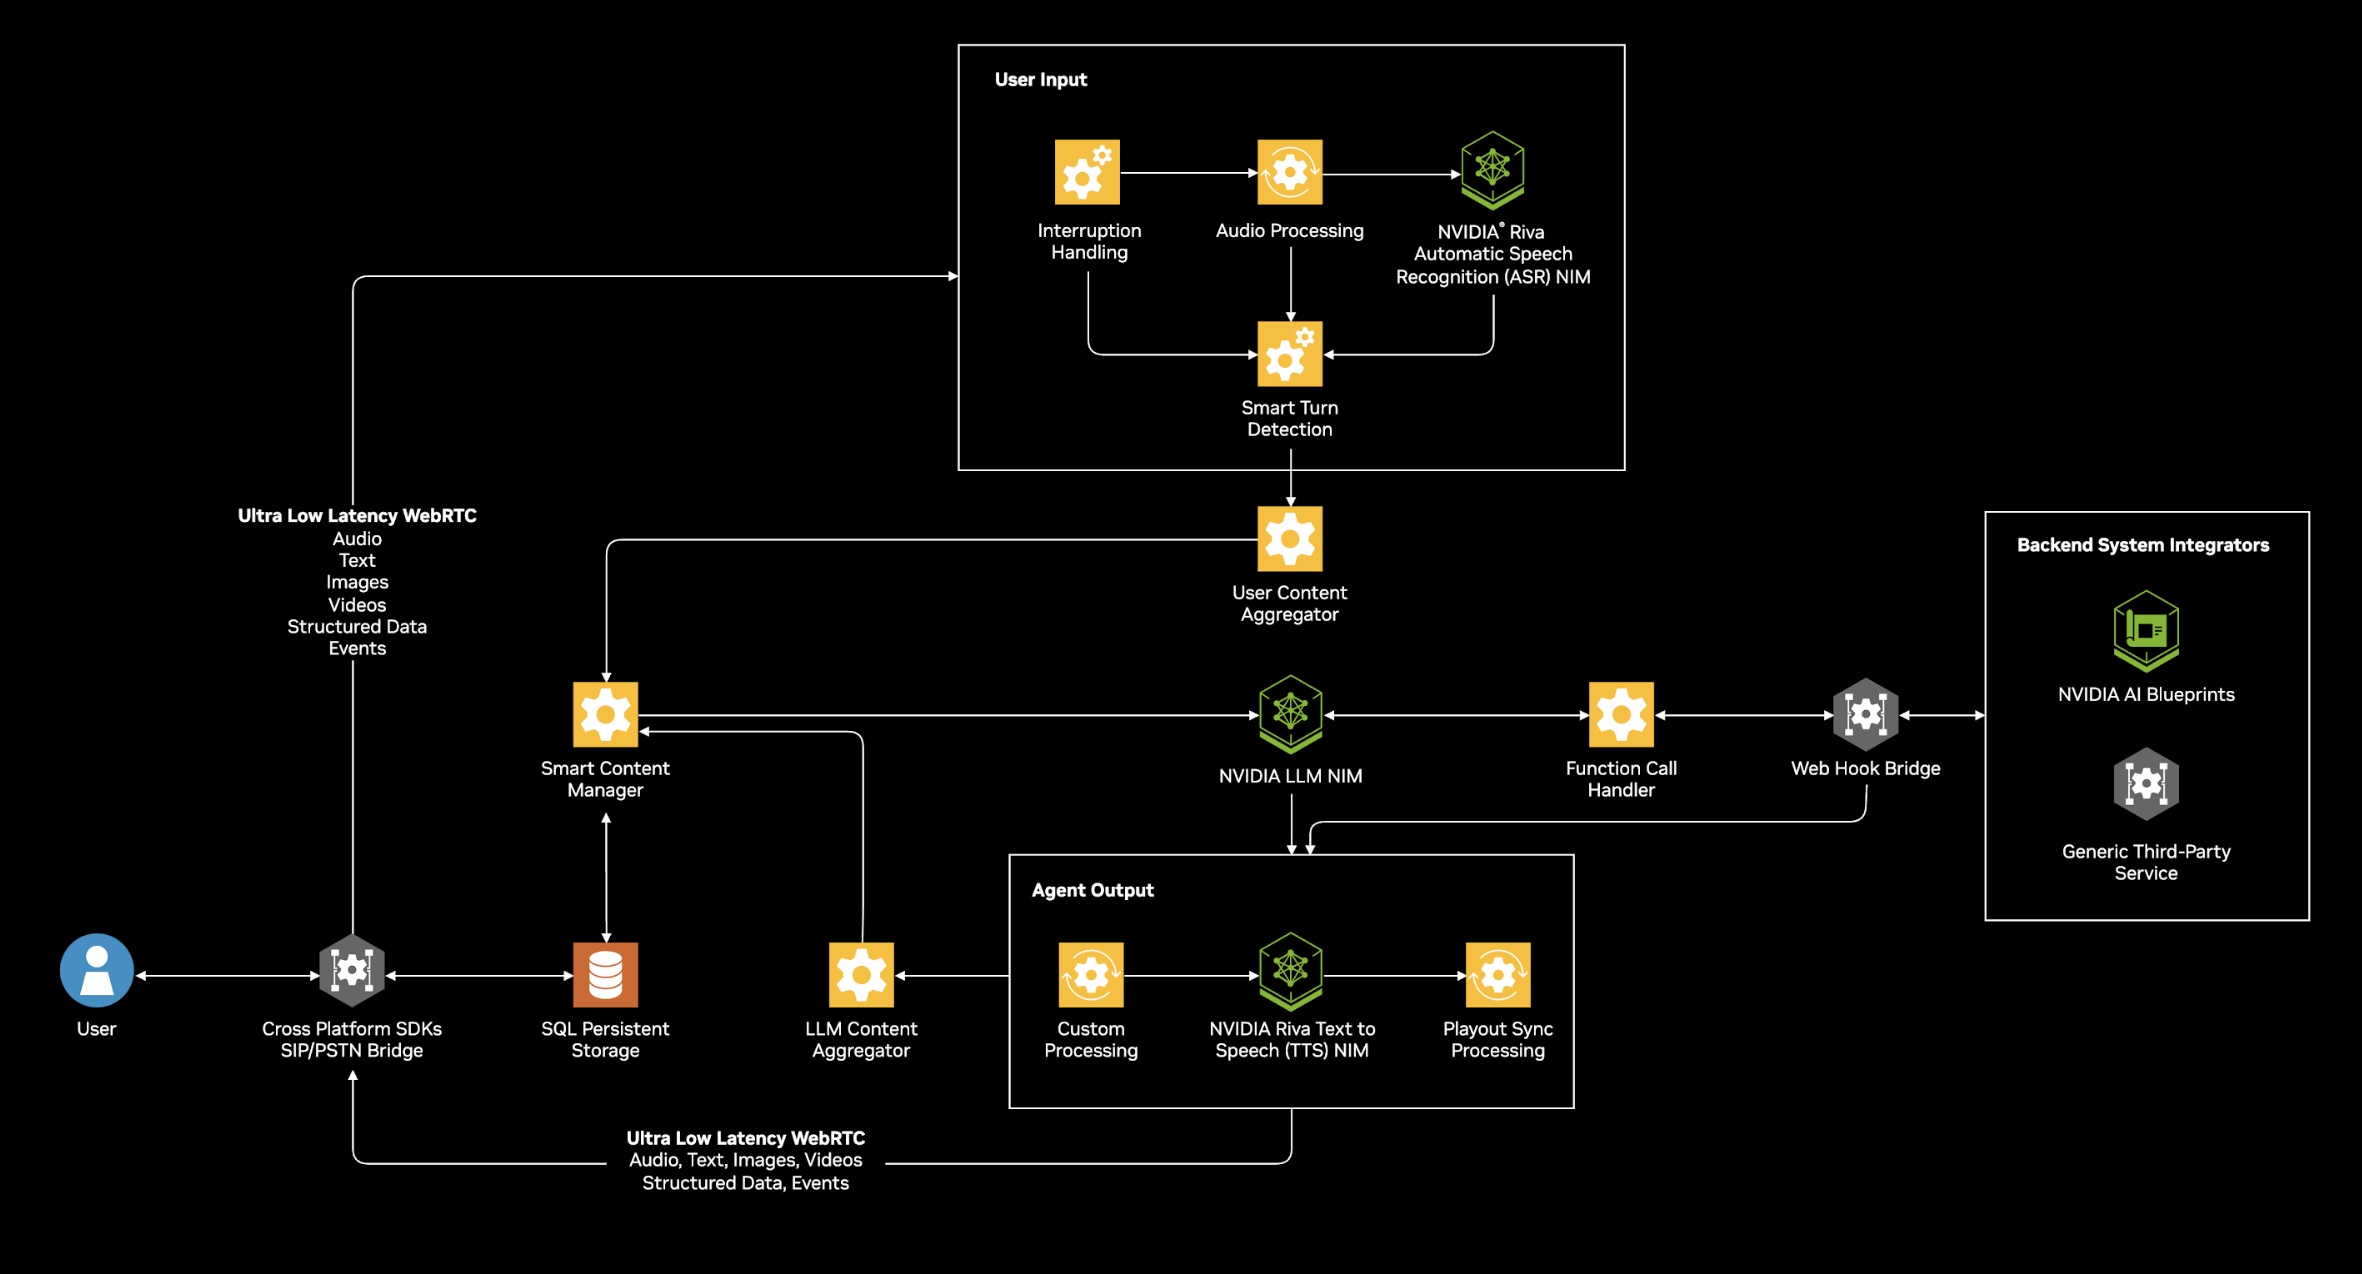
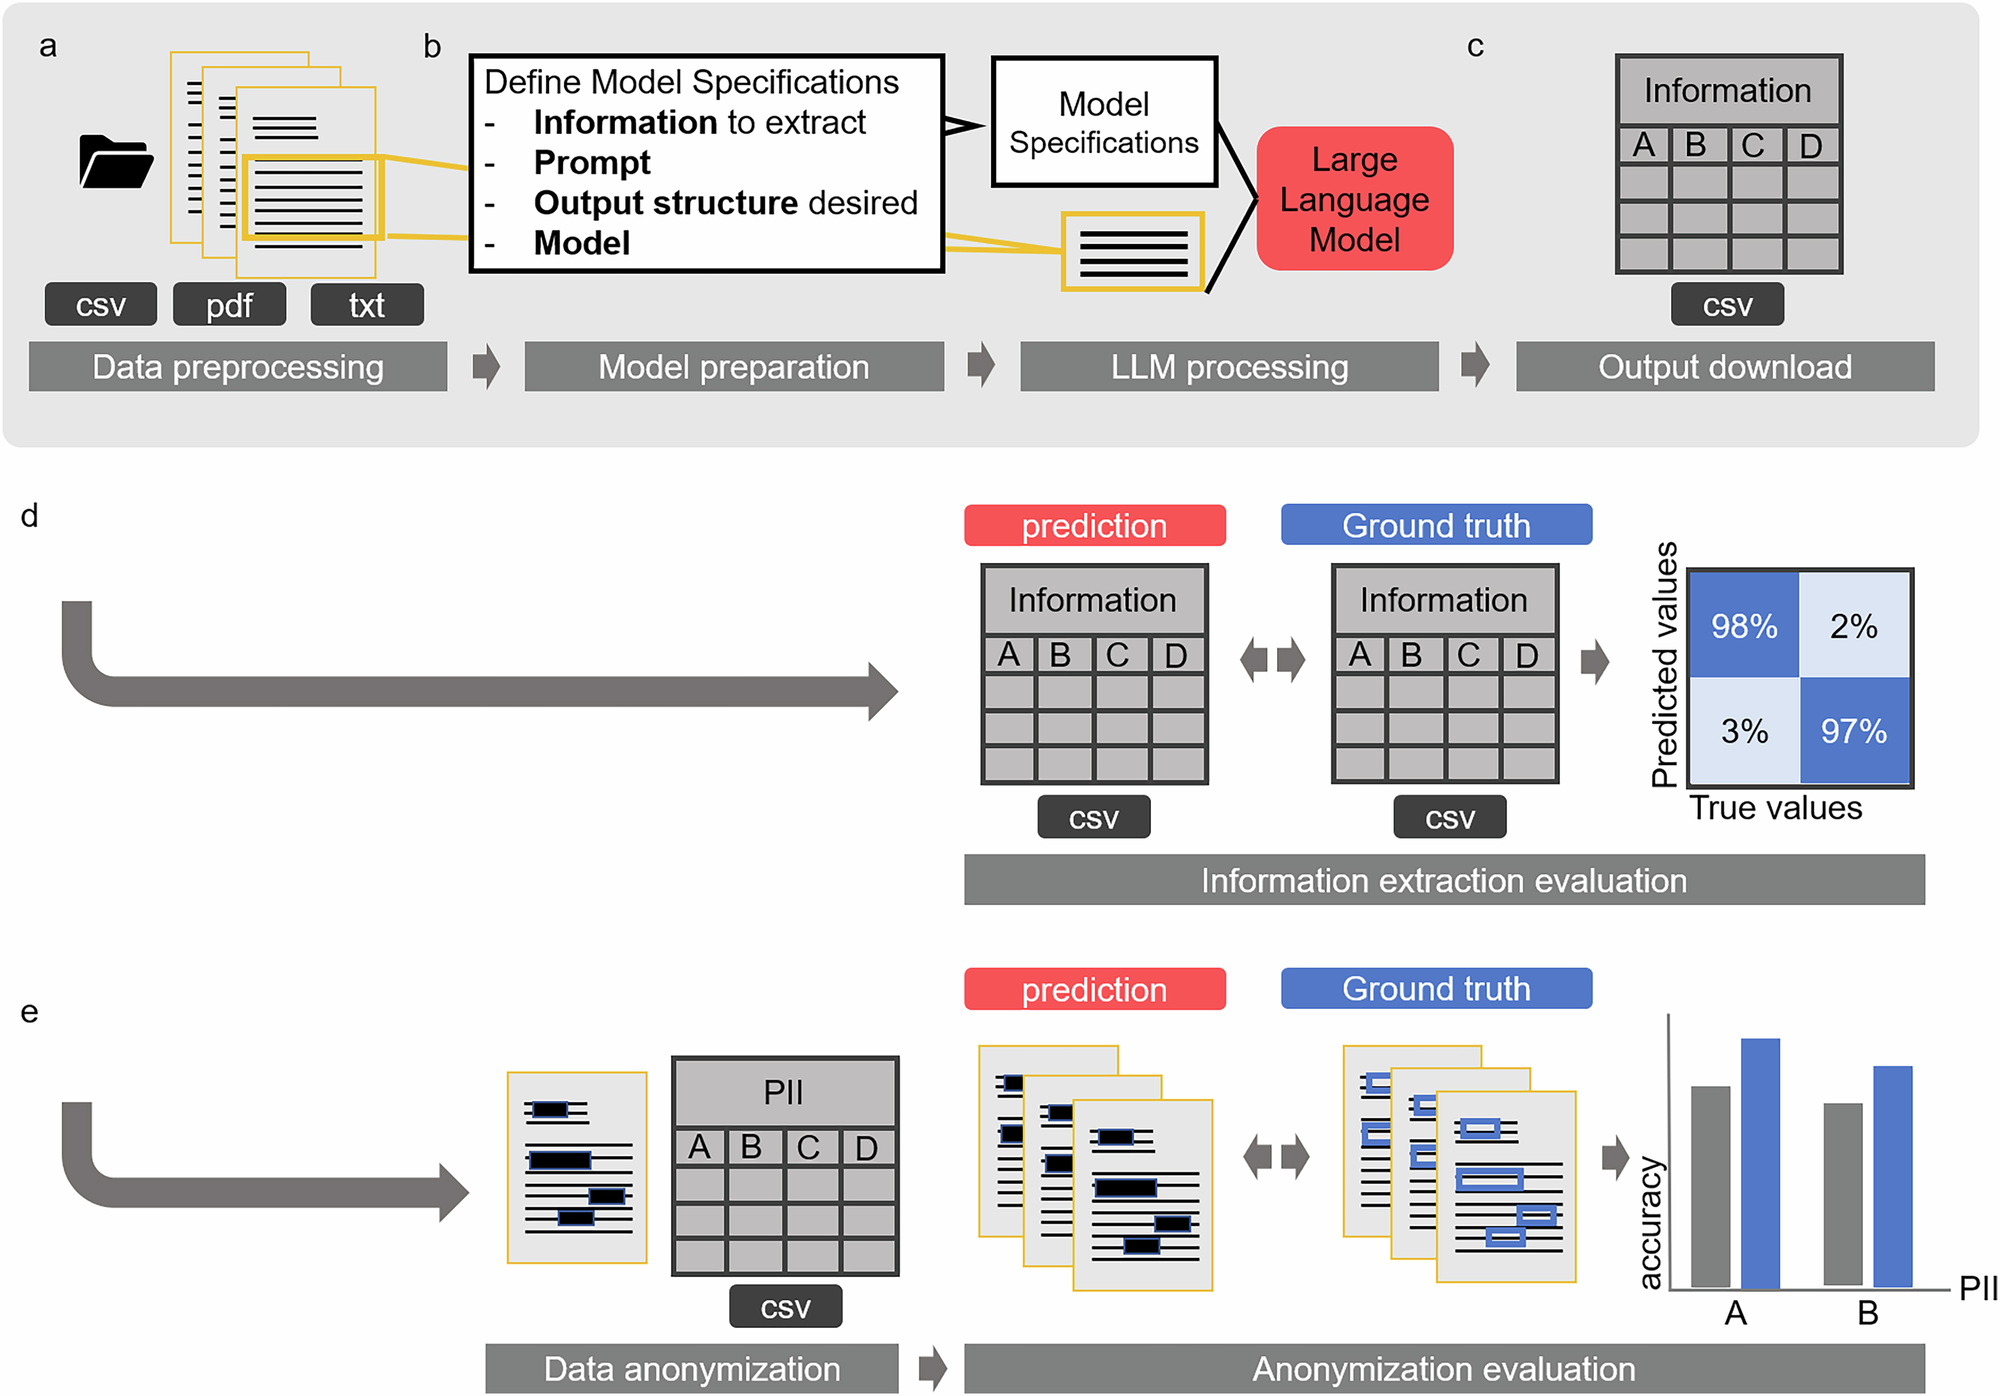
1. Загрузка .wav файла
2. STT через Google Cloud Speech API
3. Анализ текста и извлечение фактов (Gemini)
4. Генерация текста-ответа
5. TTS → аудиовыход
Что реализовано в проекте:
реализация STT-пайплайна для .wav
интеграция с Gemini API для извлечения фактов
обработка аудио → текст → смысл → текст → аудио
работа с AI-сервисами Google Cloud